Herkunft, sichtbar gemacht.
Ein selbst gehostetes Genealogie-System für Stammbäume, die man erkunden kann statt sie nur zu betrachten — mit Dokumenten, KI-Transkription, GEDCOM-Import und einer Qualitätsprüfung, die auch Dubletten findet und zusammenführt.
* Lesezugriff für alle — Schreibrechte nur mit echtem Konto, damit die Ahnen dort nicht versehentlich zweimal heiraten. † Gast-Login (falls aktiviert) reicht für Stammbaum, Ahnenfächer, Netzwerk und Karte. Für Uploads, GEDCOM-Import und die Dubletten- Zusammenführung braucht es ein Editor-Konto — beim Betreiber erfragen. ‡ Es ist eine Testinstanz. Was kaputtgehen kann, geht irgendwann kaputt — hier mit Absicht, nicht als Bug-Report willkommen.
Drei Blickwinkel auf dieselbe Familie.
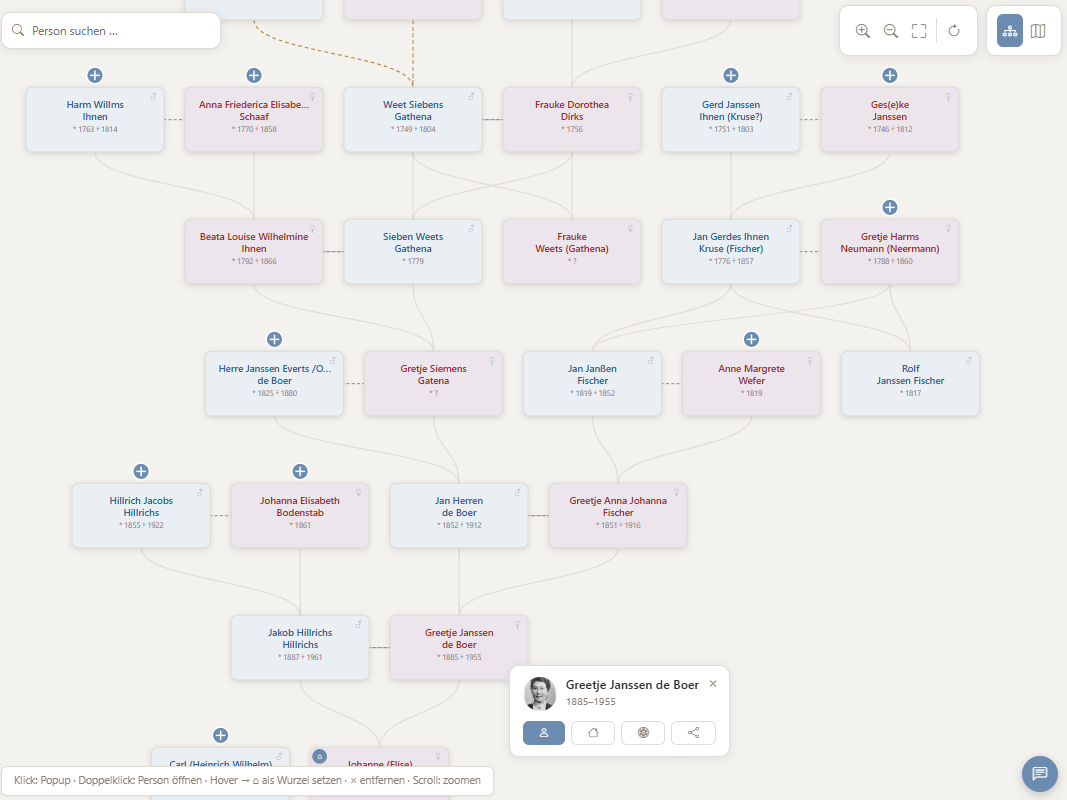
Der interaktive Stammbaum lädt Vorfahren und Nachkommen erst bei Bedarf nach, lässt sich frei zoomen und durchsuchen. Steht eine Geschwister- reihe in der falschen Reihenfolge, wird sie einfach per Drag & Drop umsortiert — die Änderung landet direkt in der Datenbank, nicht nur auf dem Bildschirm.
- Lazy-Load-Stammbaum mit Klick-Popup, Suche, Zoom
- Geschwister per Drag & Drop neu sortieren (
birth_order) - Ahnenfächer bis 6 Generationen, Zentrum frei wechselbar
- Netzwerk-Graph: Personen & Ereignisse als verbundene Knoten
- Kartenansicht (Leaflet/OSM) für alle drei Ansichten
Ereignisse mit Beteiligten, nicht nur mit Daten.
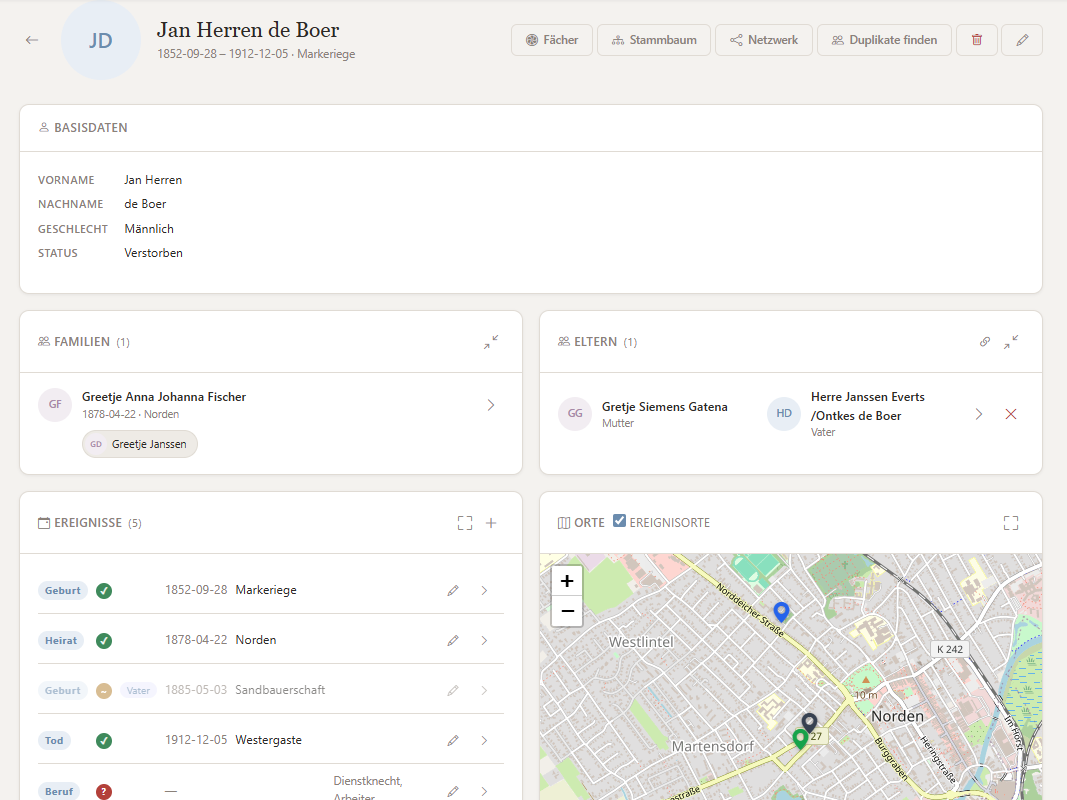
Ereignisse sind eigenständige Objekte: An einer Taufe können Täufling, Eltern, Taufpaten und Amtsperson gleichzeitig beteiligt sein, jeder mit eigener Rolle. Das Ereignis ist auch die Einheit, die belegt wird — eine Quelle mit Fundstelle, Zitat und Zuverlässigkeit hängt am Ereignis, und Person wie Familie erben das automatisch über ihre Beteiligung, ohne Doppelerfassung. Ist die Quellenlage dünn, zeigt ein kleines Badge das direkt am Ereignis — die Lebenslinie reiht alles auf einer Zeitachse auf.
- Beliebig viele Beteiligte pro Ereignis, frei erweiterbare Rollen
- Quellenzuverlässigkeit (aus GEDCOM QUAY oder manuell) mit einheitlichem Badge — gleiches Muster bei Ereignissen, Personen, Familien und Dokumenten
- Ereignisliste filterbar direkt nach Zuverlässigkeitsstufe (Primärquelle bis unbewertet oder ganz ohne Quelle) — Lücken in der eigenen Recherche gezielt aufspüren statt zufällig beim Durchklicken entdecken
- Personen- und Familienliste zeigen die Anzahl verknüpfter Ereignisse auf einen Blick
- SVG-Lebenslinie: alle Ereignisse auf einer Achse, Rand-Marker für Undatiertes
- Konfigurierbare GEDCOM-Rollenabbildung
Von der eingescannten Urkunde zum Datensatz.
Urkunden und Kirchenbuchseiten landen als Dokumentgruppen im System — mehrseitige Dokumente lassen sich umsortieren, Einzeltranskriptionen zu einem Gesamttext zusammenführen. Eine optionale KI-Pipeline übernimmt die Texterkennung; bestehende Personendaten werden dabei nie automatisch überschrieben.
- Upload mit SHA256-Duplikaterkennung, automatische Thumbnails
- Dokumentgruppen: Seiten per Drag & Drop sortieren, Gesamttext frei redigierbar
- KI-Transkription (Claude Vision oder lokal via Ollama), pro Seite abschaltbar
- KI-Review: Vorschläge annehmen, mergen oder verwerfen — nie automatisch
- Quellenbelege direkt am Dokument — mehrere Quellen, je mit Fundstelle, Zitat und Konfidenz
- Verknüpfung mit beliebig vielen Personen, Familien und Ereignissen — in beide Richtungen: bestehendes Ereignis suchen und anhängen, oder ein neues direkt aus dem Dokument heraus anlegen (automatisch als Beleg verknüpft)

Import mit Rückgrat, nicht nur ein Upload-Knopf.
Der Import läuft dreistufig — Staging, Review, Commit — und lässt sich jederzeit unterbrechen und fortsetzen. Jede eingehende Person wird gegen den bestehenden Baum abgeglichen: fuzzy Namensvergleich plus phonetische Vorauswahl, damit Meier, Meyer und Maier im selben Topf landen. Neben GEDCOM 5.5.1 versteht ahnify auch ein eigenes JSON-Schema — für Datensätze aus eigener Recherche, die mehr Datenmodell brauchen, als GEDCOM hergibt.
- Staging → Review → Commit, unterbrechbar und fortsetzbar — für beide Formate identisch
- Dubletten-Erkennung: Fuzzy-Matching + phonetischer Vorfilter, mit Konfidenz-Score
- Quellenbelege inkl. QUAY-Zuverlässigkeit werden mitimportiert
- JSON-Schema zusätzlich mit echten Beteiligten-Rollen, Zitat-Seite/-Text, Orts-Koordinaten und Quellen-Hierarchie (
parent_ref) - Vollständiger GEDCOM-Export inkl. Ereignissen, Quellen, Notizen, Datums-Qualifikatoren
Struktur statt Zettelwirtschaft.
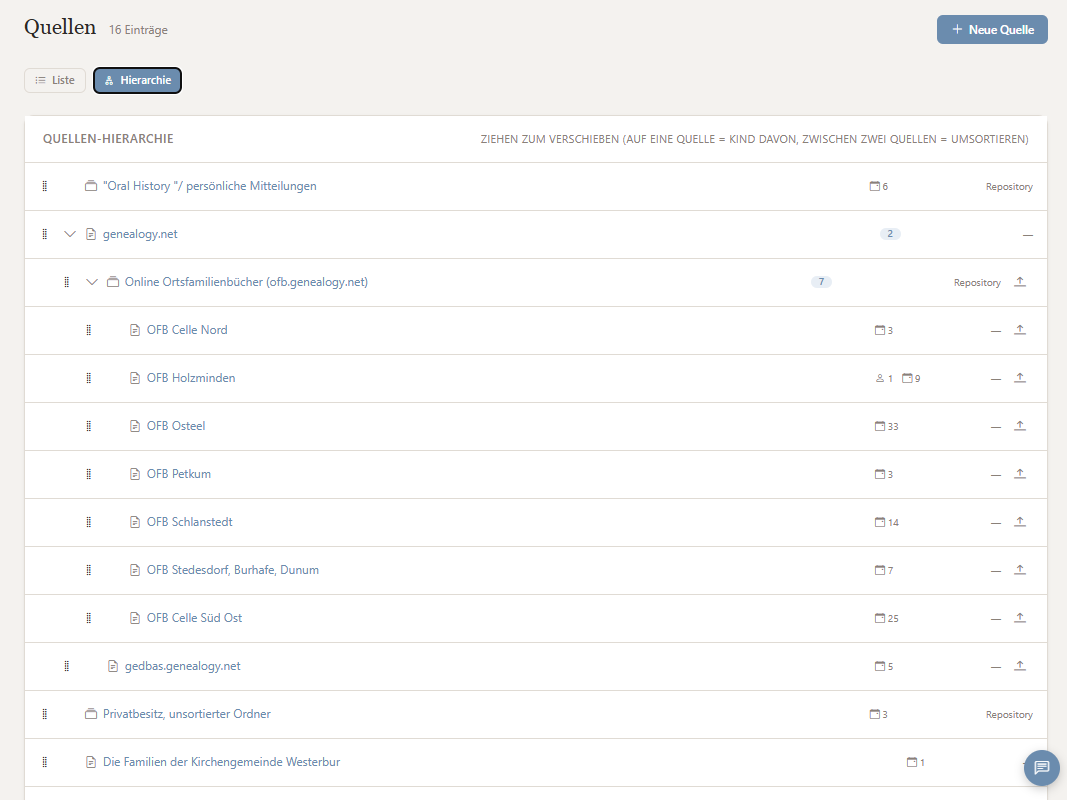
Ein Import bringt schnell ein Dutzend Einzelartikel derselben Publikation mit — ohne Gruppierung ballert das die Quellenliste zu. Quellen lassen sich deshalb hierarchisch anordnen (Repository → Publikation → Artikel), sichtbar und verschiebbar als Inhaltsverzeichnis im Hierarchie-Tab.
- Auf-/zuklappbarer Baum, beliebig tief
- Drag & Drop zum Umhängen zwischen Ebenen und zum Umsortieren von Geschwistern
- Zyklus-Schutz: eine Quelle kann nicht zu ihrem eigenen Nachfahren werden
- JSON-Import kann die Gruppierung direkt mitliefern (
parent_ref) - Optionale Standard-Zuverlässigkeit je Quelle — Vorbelegung für neue Zitate, ändert bestehende nicht
Vom Freitext zur echten Ortshierarchie.
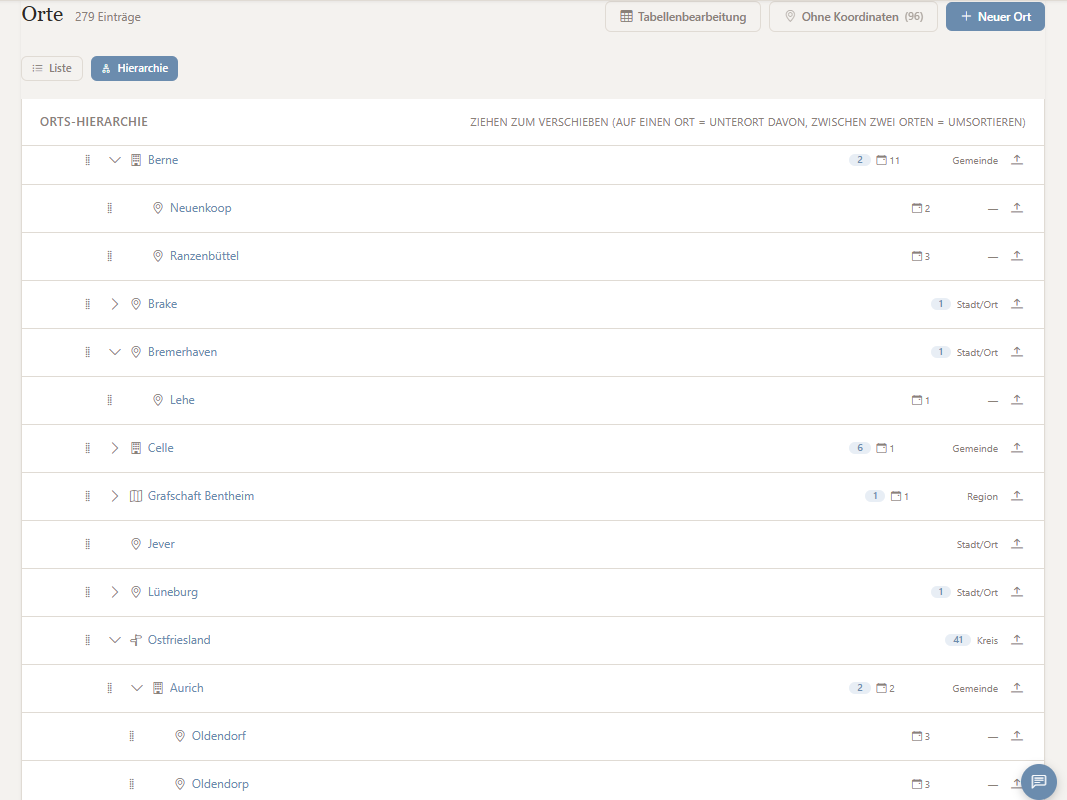
„Ort, Gemeinde, Kreis, Land" als Freitext eingetippt — ahnify zerlegt das beim Speichern selbst in die passende Eltern-Kette und legt fehlende Zwischenebenen an, statt alles als eine einzige, flache Liste zu führen. Historische Bezeichnungen, die Nominatim nicht kennt, lassen sich trotzdem verorten: Pin manuell auf der Karte setzen, statt auf Geocoding zu warten.
- Automatische Zerlegung kommagetrennter Ortsangaben in eine Eltern-Kette, analog zur Quellen-Hierarchie
- Hierarchie-Tab mit auf-/zuklappbarem Baum, Drag & Drop zum Umhängen und Umsortieren
- Geocoding über Nominatim (OpenStreetMap) — einzeln oder als Batch, kein API-Key nötig
- Manuelles Setzen des Karten-Pins, wenn Nominatim eine historische Bezeichnung nicht findet
- Orte zusammenführen: Feld-für-Feld-Vergleich, Verknüpfungen wandern automatisch auf den behaltenen Ort
Der Baum bleibt sauber — auch mit Handarbeit.
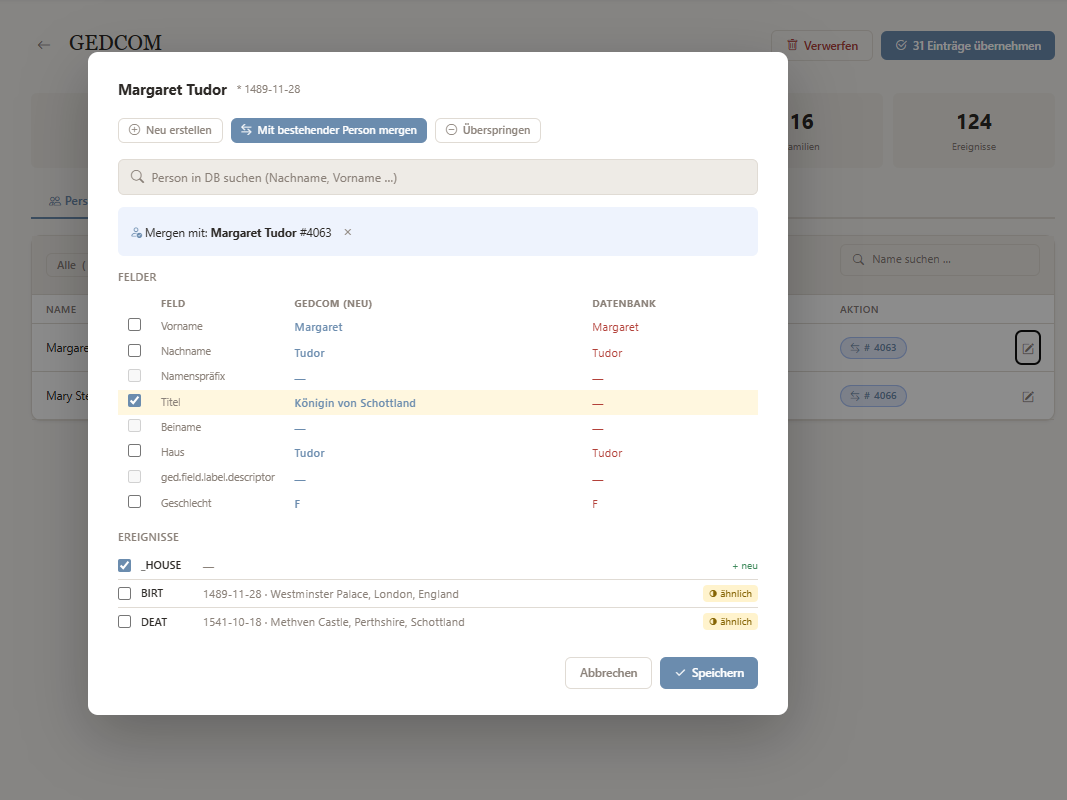
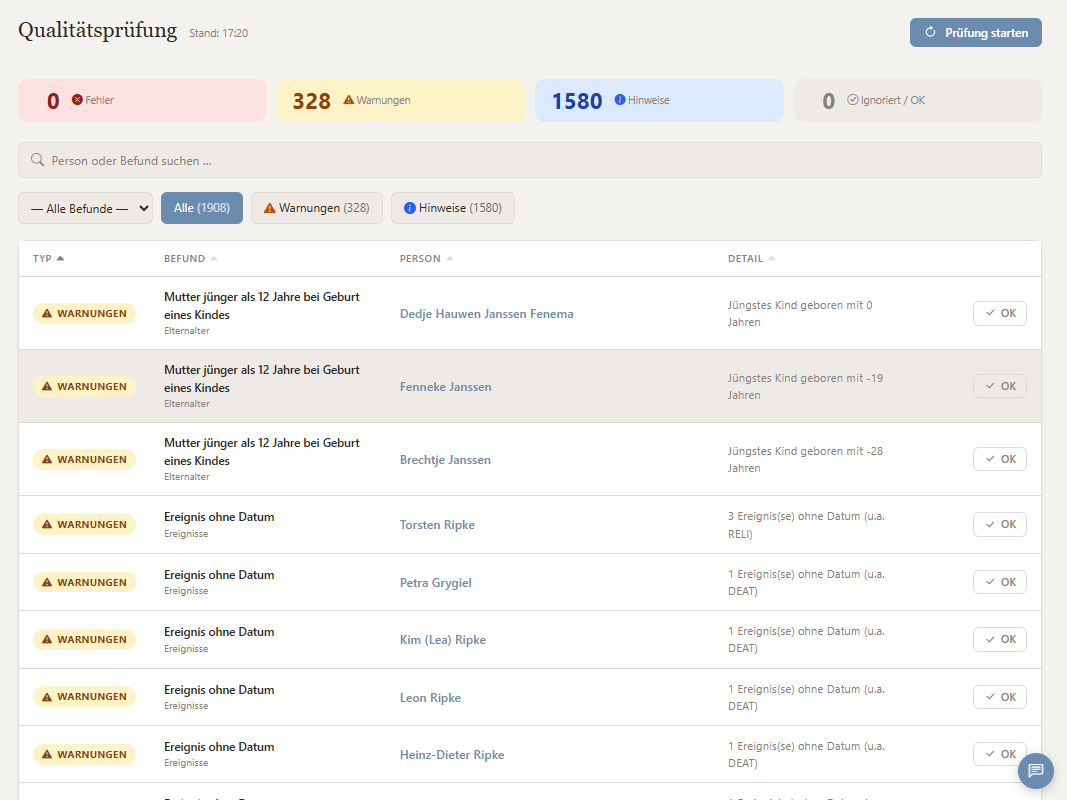
Über fünfzehn regelbasierte Prüfungen decken Chronologie-Fehler, fehlende Quellen oder verwaiste Dateien auf. Ein datenbankweiter Dubletten-Scan findet doppelt angelegte Personen unabhängig vom Import — und schlägt sie zum Zusammenführen vor, Feld für Feld, mit automatischer Übernahme aller Verknüpfungen.
- 15+ Regeln: Chronologie, doppelte Ereignisse, fehlende Quellen, verwaiste Dateien
- DB-weiter Dubletten-Scan, unabhängig von jedem Import
- Ähnlichkeitssuche mit Jaro-Winkler + Kölner Phonetik — erkennt auch deutsche/friesische Schreibvarianten (Ukena/Uken, Meier/Meyer/Maier)
- „Duplikate finden"-Knopf direkt auf der Personenseite, nicht nur im DB-weiten Scan
- Manuelles Merge: Feld-für-Feld-Vergleich, Fremdschlüssel werden automatisch umgehängt
- Ignorierliste für bewusst akzeptierte Befunde
- Gezielte Spaltensuche in jeder Liste (
geburtsort:Esens,typ:Urkunde, …) — schnell nachsehen, wo genau noch etwas fehlt, statt sich durch Freitext-Treffer zu wühlen
Zahlen, die etwas über den Baum verraten.
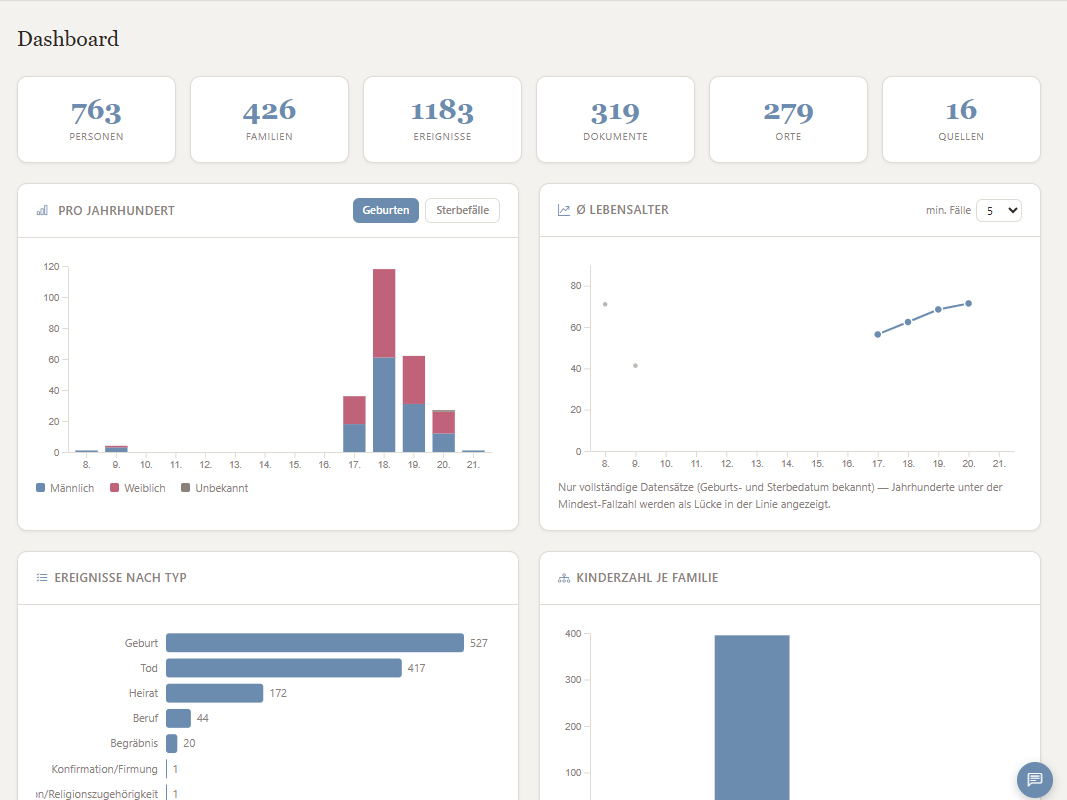
Kein Sammelsurium aus Zählern — jede Kachel und jedes Diagramm liest etwas aus den echten Daten heraus, das man sonst mühsam zusammensuchen müsste: von der Verteilung der Geburten über Jahrhunderte bis zur Frage, wie viele Zweige der Baum eigentlich hat und wie lang die längste bekannte Generationenkette wirklich ist.
- Geburten/Sterbefälle pro Jahrhundert, gestapelt nach Geschlecht, per Toggle umschaltbar
- Ø-Lebensalter-Trend mit einstellbarer Mindest-Fallzahl — dünn belegte Jahrhunderte verfälschen die Linie nicht
- Ereignistyp-Verteilung, Kinderzahl je Familie, häufigste Vor-/Nachnamen und Geburtsorte
- Beleg-/Datenqualitäts-Score: Anteil Ereignisse mit Quelle, Verstorbene mit vollständigen Lebensdaten, Personen mit Dokument
- Baumstruktur-Analyse per Graphenalgorithmus: zusammenhängende Zweige und der längste Generationen-Pfad, beide direkt anklickbar in den Stammbaum
- Alle Kacheln respektieren die Rolle des Betrachters — Gäste sehen nur, wofür sie Leserechte haben, statt eines dauerhaften Ladezustands
Vier Rollen, ein Gastzugang, echte 2FA.
Jede Rolle trägt ein eigenes Capability-Profil — wer private oder lebende Personen sehen darf, ist serverseitig durchgesetzt, nicht nur im UI versteckt. Zwei-Faktor-Authentifizierung mit Backup-Codes lässt sich freiwillig oder adminseitig verpflichtend aktivieren.
- 4 Rollen mit granularen, einzeln schaltbaren Capability-Profilen
- Privacy by Design & by Default (Art. 25 DSGVO) — Datensparsamkeit ist in der Architektur verankert, keine nachträgliche Einstellung
- TOTP-2FA + herunterladbare Backup-Codes, E-Mail-Code als Fallback
- Öffentlicher Gastzugang, an- und abschaltbar
- Audit-Log: wer hat wann was gesehen, geändert, gelöscht (Personen, Familien, Ereignisse, Dokumente, Konto — Rollout auf weitere Bereiche läuft)
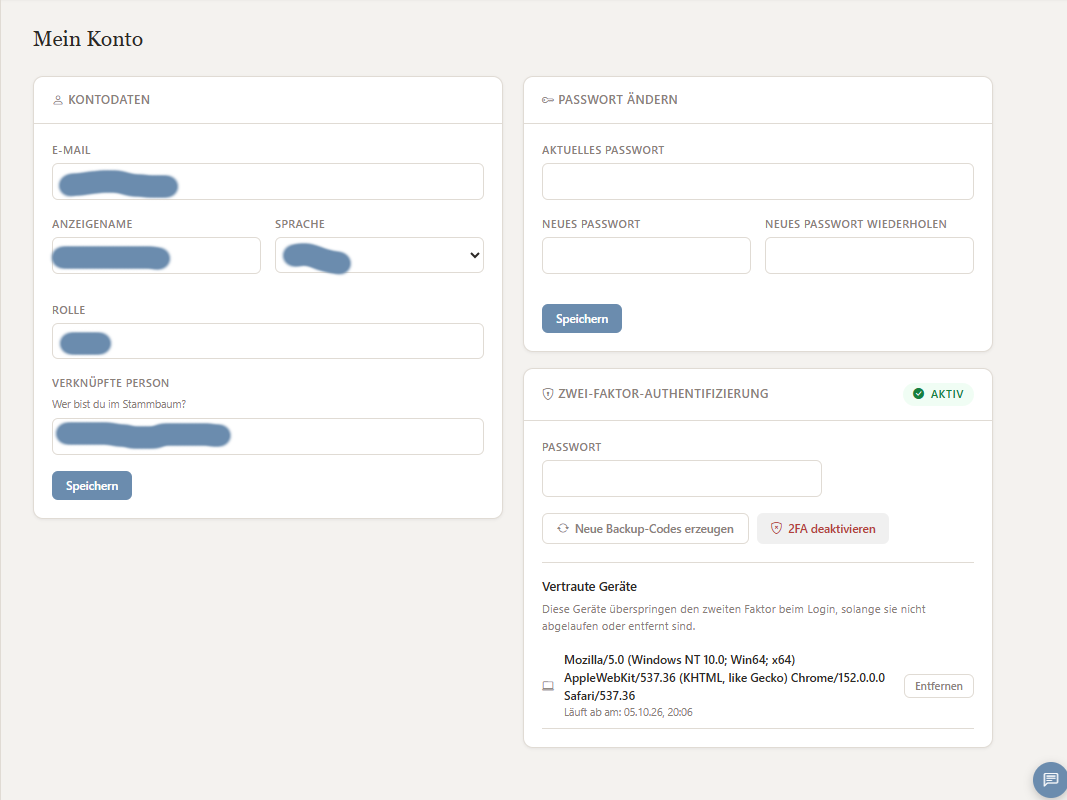
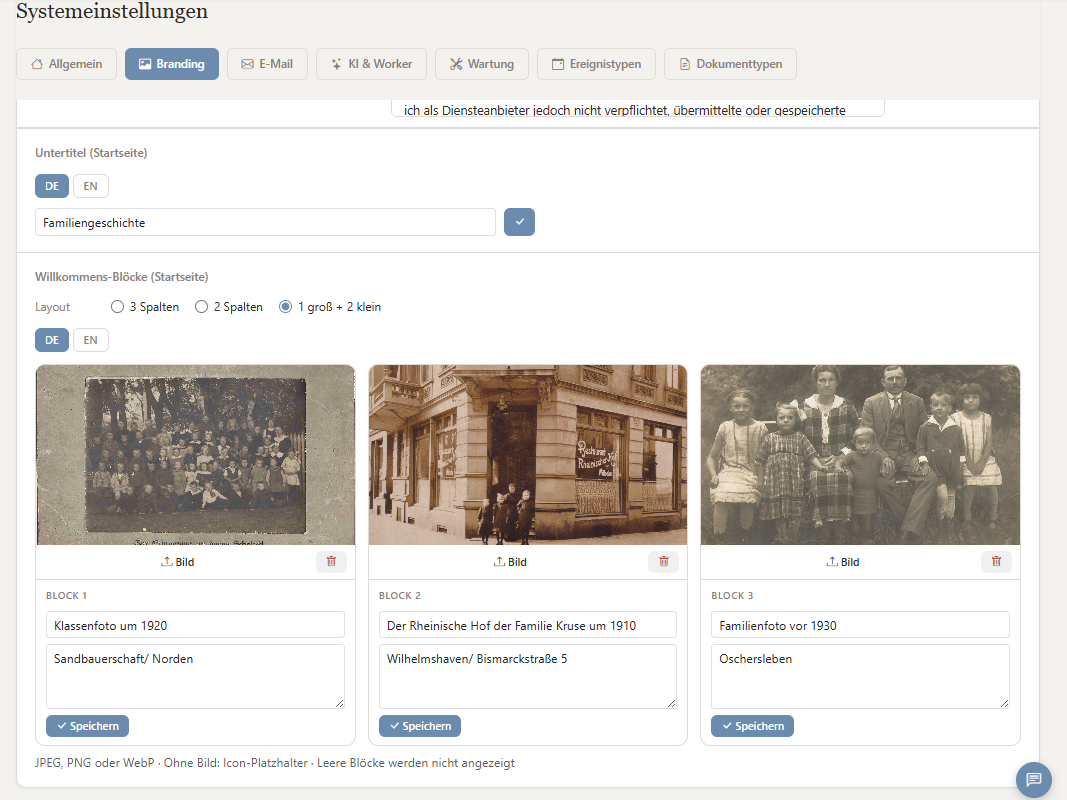
Eigene Instanz, eigene Handschrift.
App-Name, Willkommenstexte, Impressum und Datenschutzerklärung lassen sich vollständig über die Admin-Oberfläche pflegen — kein Deployment nötig. Die Oberfläche spricht Deutsch und Englisch gleichwertig, inklusive Dark Mode.
- Willkommensseite: Layout, Texte, Bilder — alles per Admin-UI
- Deutsch/Englisch vollständig zweisprachig, ohne Seitenreload
- Dark Mode, anpinnbare Sidebar
- Stammbaum-Startperson frei konfigurierbar
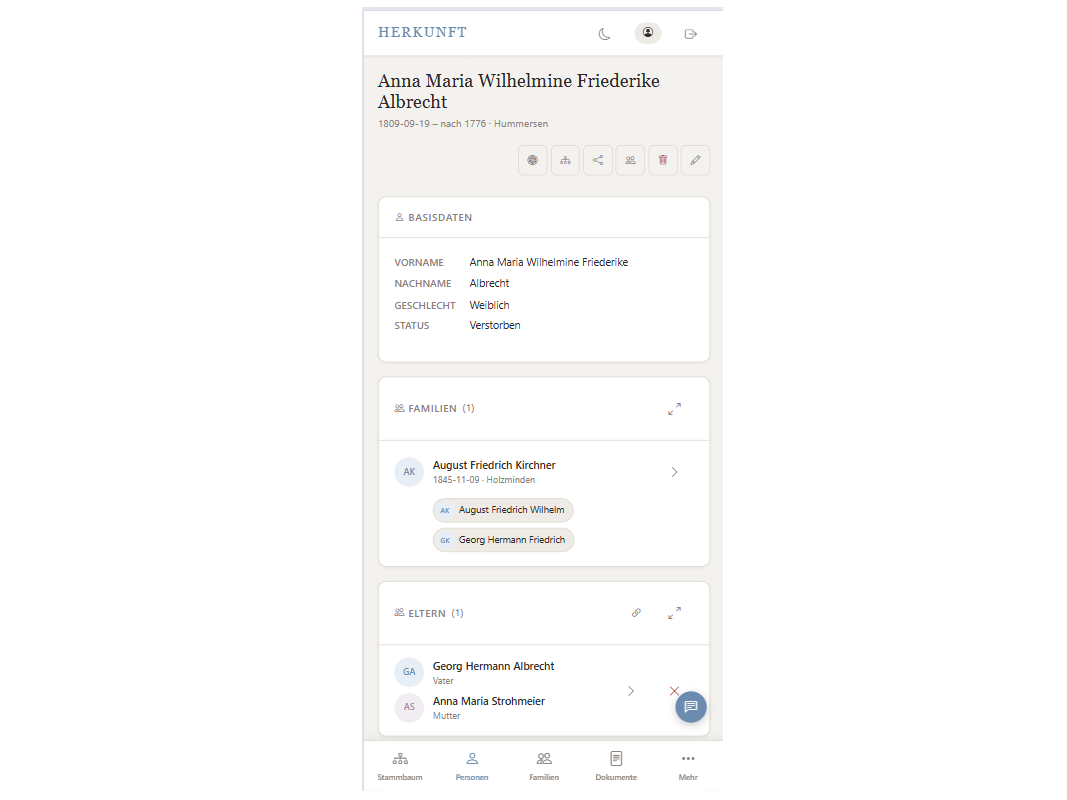
Durch die Familie scrollen — auch unterwegs.
Stammbaum, Ahnenfächer, Netzwerk, Personen, Familien und Dokumente sind auf dem Handy vollständig nutzbar — eigene Bottom-Navigation statt Sidebar, Karten statt Tabellen, Pinch-Zoom und Tap-Popups in allen drei Baum-Ansichten. Bearbeitet wird bewusst weiter am großen Bildschirm: Formulare bleiben auf dem Handy blockiert, statt unbrauchbar angezeigt zu werden.
- Bottom-Navigation ersetzt die Sidebar unter 640px Breite
- Personen, Familien, Orte, Quellen als Tap-Karten statt Tabellen
- Stammbaum, Ahnenfächer, Netzwerk mit Pinch-Zoom & Tap-Popups
- Foto- und Dokumenten-Galerie mit Wisch-Navigation
- Bearbeiten-Dialoge werden auf dem Handy gezielt blockiert statt kaputt dargestellt
Selbst hosten — oder hosten lassen.
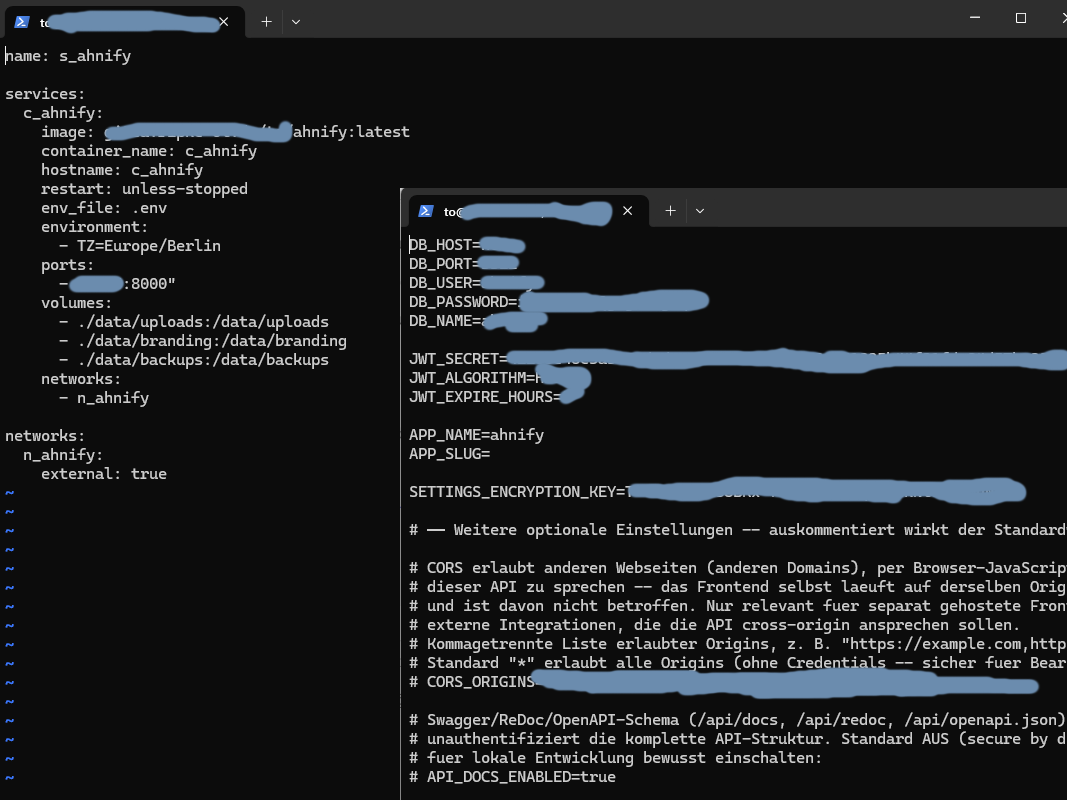
ahnify läuft in einem einzelnen Docker-Container gegen eine eigene MariaDB — volle Kontrolle, keine Abo-Bindung, Daten bleiben jederzeit exportierbar. Wer sich das nicht selbst ans Bein binden will: ahnify lässt sich auch für dich betreiben, auf einer eigenen Subdomain oder deiner eigenen Domain.
- Ein Container, eine externe MariaDB — kein Cloud-Zwang, keine Mehr-Container-Choreografie
- Vollständige Anleitung inkl. Update-Ablauf: Installation & Betrieb
- Managed Hosting auf Anfrage — Subdomain oder eigene Domain, kein automatischer Checkout
- Jederzeit exportierbar (GEDCOM 5.5.1, JSON) — keine Abhängigkeit vom Betreiber